大模型一体机,开始缩水了
(本文作者为 半导体产业纵横,钛媒体经授权发布)
文 | 半导体产业纵横
大模型一体机是集成 AI 加速硬件(GPU / 国产 AI 加速卡)、服务器硬件、推理框架、大模型权重、配套运维与应用平台的一体化设备,实现开箱即用,面向政府、企业、科研机构完成本地私有化大模型部署,省去用户自行组装服务器、适配框架、调试模型的复杂流程。
去年年初,DeepSeek R1 正式亮相,带动 DeepSeek 一体机迅速走红。DeepSeek一体机可在单机环境下完成 671B 满血版大模型的部署,一时间,各地机构、企事业单位与中小企业纷纷采购,市场热度高涨。
而如今,随着市场变化和模型进化,大模型一体机市场出现了深刻变革。
饱受争议的DeepSeek一体机
2025 年春节前后,DeepSeek R1横空出世,相关热度持续攀升,随后60多家厂商推出DeepSeek一体机。但随之而来的便是各种争论,大家都在讨论,各个相关单位是否应该部署一体机?毕竟一台一体机甚至要卖到上百万的价格,财务支出巨大。而如果调用云端大模型,几百年也用不完。加之大模型持续迭代、参数量不断膨胀,单机硬件的算力上限便会逐步显现。
仅仅三个月,市场便迎来降温。行业形成一种共识:DeepSeek有用,但DeepSeek一体机真没用。毕竟一台标准 DeepSeek 一体机至少需要搭载 8 张 GPU 显卡,受限于单机架构,无法享受集群部署带来的规模效应,综合使用成本居高不下。更关键的是,早期不少一体机本质只是硬件打包产品,软件层面优化不足,仅完成模型简单安装部署。虽然标称支持 671B 大模型运行,但实际并发能力很差,多用户同时访问极易出现卡顿。部分厂商重硬件交付、轻后续运维,设备交付之后缺少模型持续更新迭代服务,需要用户投入额外人力进行二次改造,这也造成不少机构硬件到位,业务却跑不起来。而且满血版一体机普遍要120万到150万,用国产卡因单台显存不够,往往要两台并联,预算近400万。到2025年下半年,“满血版卖不动了”已经不再是秘密,中小厂商的成单主力悄悄换成了32B和70B。
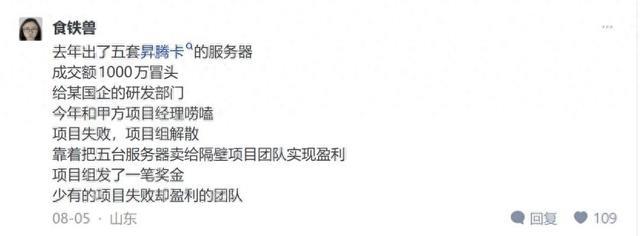
时间来到 2026 年,市场环境再度发生变化。内存、存储(SSD、机械硬盘等)、GPU 芯片等等相继涨价。从资产角度来看,2025年初购入的一体机,如今二手处置甚至可以收回全部采购成本,还能实现盈利。有网友透露,公司去年出了五套昇腾卡的服务器给某国企的研发部门,成交额1000万冒头。今年和甲方项目经理了解到,项目失败,项目组解散,靠着把五台服务器卖给隔壁项目团队实现盈利,甚至项目组发了一笔奖金,成为了少有的项目失败却盈利的团队。当初被网友调侃高价踩坑的采购方,反倒成了本轮硬件涨价周期里的受益者。
但这里需要客观看待硬件增值现象,虽然硬件账面升值,并不代表适合当下新项目采购。二手一体机普遍面临保修失效、固件驱动兼容性、功耗过高等现实问题,老旧硬件架构想要跑通 DeepSeek V4.1 Flash 这类新一代 MoE 模型,还需要完成推理框架改造,并非拿到设备即可直接满血运行,这也抑制了机构大规模囤二手设备的意愿。
大模型一体机集体“缩水”
今年的行业风向已经转变,市场不再追捧能够运行 671B 满血大模型的一体机,AI BOX 这类轻量化本地部署设备开始兴起。相比于去年的671B 满血模型的高端一体机,今年市面一体机硬件配置、可承载模型参数量均出现明显下调,多数中端设备最多仅可运行 70B 级别模型。
缩水的原因并不复杂。一是需求端在挤泡沫,大量实践证明,绝大部分用户需求的是知识库问答、公文写作等场景,而这类场景依靠蒸馏的小模型就足够了,671B的能力大部分时间能力过剩;二是模型端的能力密度在提升,MoE稀疏激活、蒸馏、量化等技术成熟,达到同样效果所需的参数量大幅变小;三是高端芯片供给受限,2025 年 4 月,H20 芯片被无限期停售,而彼时国产加速卡经过迭代,在显存、吞吐性能上有一定提升,但单卡依然跑不动超大 MoE 模型,想要实现满血运行,需要多台设备并联。除采购成本外,多卡并联还会带来调试复杂、软件生态适配工作量大等问题,进一步抬高项目落地门槛;四是内存涨价,本地部署满血版成本上涨过高,性价比不足。
整个一体机市场,由此劈成了两半:轻量化缩水版本主打走量,撑起市场出货大盘;满血高端一体机产品依然存在,但采购群体高度集中于有强合规要求的央国企、金融机构,高端机型整体出货量大幅下滑。
内存、Token涨价,Agent爆火
在一体机普遍走向轻量化的当下,高端一体机是否还有市场价值?实际上,高端一体机在特定场景下,仍存在市场需求。
首先是复杂生产场景,小模型能力存在明确短板。Agent 长链路任务、Vibe Coding 工程级代码开发、AI 专业视频生成,这三类当前增长最快的 AI 应用,对模型的推理深度、逻辑链条、多模态理解能力要求极高。想要稳定支撑这类生产级任务,必须部署满血版的大模型。也正是这个原因,高端一体机并没有因为轻量化产品流行而消失,反而在真正的生产环节价值更加凸显。
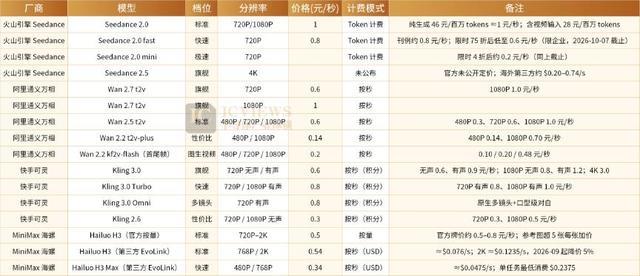
其次,云端调用成本飙升,本地部署性价比凸显。随着 Token 价格上涨,再加上海量多模态生成消耗,大规模使用云端大模型的成本正在快速攀升。Vibe Coding 需要反复迭代、大量生成调试;AI 视频生成更是按秒计费,单条视频成本可达数元至数十元。当业务量上来之后,云端订阅费用会非常惊人,年投入很容易突破百万级别,本地部署大模型的成本优势重新显现。与此同时,数据安全的重要性愈发凸显。就在不久前,海外曾曝出公开用户数据的安全事件,海外闭源 AI 产品也开始嵌入隐形水印等机制,企业与机构对数据本地化的诉求持续增强。
最后,Agent 普及推高本地部署利用率。过去一体机最受诟病的一点,是利用率不足,百万级设备大部分时间在闲置。但Agent 的流行,可以让一体机连续工作,利用率飙升,理论上可以拉高设备利用率。通过工作流编排与业务系统深度对接,一体机可以承载持续运转的 Agent 任务,实现 7×24 小时不间断推理。
开源模型更新,一体机迎来能力升级拐点
真正的行业转折点来自新一代模型迭代,大模型本身能力持续变强。Kimi K3 虽然性能出众,但参数量庞大,很难在一体机硬件上落地部署。而新模型的出现改变了这一局面。
首先是 DeepSeek V4.1 Flash 正式发布,它以接近 Pro 版本的能力,提供 Flash 档位的使用成本。根据官方介绍,V4.1 Flash 在性能、开销、推理速度、任务总耗时等多项指标上全面超越 V4 Pro。该模型采用全新架构,原生支持视觉理解,承接上一代 Pro 模型的定位。尤为关键的是,V4.1 Flash 基于 CausalEncoderDecoder(因果编码器解码器)架构打造,属于总参数量 552B 的 MoE 混合专家模型。
需要注意的是,552B的模型大小,小于DeepSeek R1满血模型671B的参数规模。这意味着去年花150万买的满血一体机,不用加一张卡就能原地升级,能力原地提升。能力更强,上下文也达到最新水平,模型还没有变大。而且模型与Harness框架联合训练,强化了长周期连续任务处理能力。
其次,MiniMax H3 开源模型快速走红。MiniMax H3是MiniMax发布的一款通用全模态生成模型,于2026年7月31日正式发布。2026年8月3日,MiniMax正式开源该模型,其开源许可明确排除美国、欧盟、英国及韩国的使用权限,华为昇腾、摩尔线程、沐曦、海光信息、昆仑芯、天数智芯、壁仞科技、AMD、Intel等国内外芯片厂商,以及Hugging Face、魔搭ModelScope、ComfyUI、RunningHub、fal等开发社区和云推理平台,另有vLLM-Omni、SGLang等推理框架完成适配支持,该模型在Artificial Analysis榜单中视频编辑能力排名第一。
云端服务商的AI视频生成有多费钱就无需赘言了,而H3模型综合能力突出,让 AI 视频的本地生成成为现实,降低了企业对商用云端视频生成服务的依赖。而且经过社区优化后,MiniMax H3甚至可以在9700x + 32G内存 + 5070ti的配置上能跑,大概5分钟一个5秒的视频,可想而知一体机在优化后,输出速度将会更快。最近的一条消息称,同样生成5秒、1344×768的视频,在4张RTX 6000D上,原始BF16 50步方案耗时348.8秒,差不多6分钟。RunningHub H3 Lightning完整加速之后,只需要28.7秒。前后约12倍提速,生成耗时减少约92%,却依旧能保留BF16数值精度。RunningHub已经把整套玩法放GitHub上开源了,任何创作者都能开箱即用!在8张RTX 6000D环境下,让H3做一个15秒、分辨率768×1344的视频,纯文字生成大约需要48秒、双参考图生成约73秒。一条15秒的图生视频,可以打进“1分钟出结果”这个时间尺度了。
总结
综合来看,去年上半年入手高端一体机的采购方,在本轮硬件涨价周期中获得资产层面的收益。2026 年市场呈现两极分化:满血高端一体机硬件成本抬升,性价比有所下降,仅建议有刚性业务、合规隔离需求的机构采购。同时必须注意,一体机采购并非一劳永逸,除硬件采购预算外,机构还需要持续承担机房供电散热、运维人力、模型版本迭代、推理框架调优、故障维护等隐性成本;不少单位只核算硬件支出,忽略后续运维开销,最终造成项目落地不及预期。轻量化的 AI BOX 类设备迎来普及,更适配具备本地保密诉求、AI 能力要求不高的业务场景。
未来,一体机行业不会简单走向“越做越小”,产品分层格局还会持续演化。一方面轻量 AI BOX 将进一步下沉,覆盖更多边缘、部门级业务;另一方面随着国产芯片、MoE 推理框架持续迭代成熟,未来高端满血一体机的综合成本存在下探空间。往后一体机赛道的竞争,不再比拼谁能够部署最大参数量的模型,而是硬件、推理框架、模型适配、业务应用与运维服务整套方案的综合实力。
大家都在看
-
Personal AI assitant 为什么集体“长出了脸”? 从Grok Bot到Meta Muse,再到OpenAI Dots,AI助手为何集体“长出脸”?这不仅是萌化设计,更是系统状态可见性的功能升级。本文从体验设计视角拆解四类“脸”的玩法,对比NOMI与国内产品路线,揭示情感化设计背后的产 ... 机械之最10-03
-
电子行业登顶9月私募调研榜首,这些个股最受青睐 9月私募调研动向揭晓。私募排排网数据显示,截至9月30日,当月共有726家私募参与A股调研,覆盖30个申万一级行业中的391只个股,合计调研达1808次。9月私募调研聚焦于6大行业,被调研次数均不少于100次,合计调研1327 ... 机械之最10-03
-
Mate40 Pro凭啥封神?不只是能打,还有机圈独一份的情怀 华为Mate系列一波接一波,新机黑科技也是一层叠一层,可隔了这么多年,Mate40 Pro照样牢牢占着机圈“一代神机”的位置。不少用户换了新旗舰,也还是舍不得让这台老机闲着。大家对它的偏爱,早就不只是一台普通手机那 ... 机械之最10-03
-
大模型一体机,开始缩水了 (本文作者为 半导体产业纵横,钛媒体经授权发布)文 | 半导体产业纵横大模型一体机是集成 AI 加速硬件(GPU / 国产 AI 加速卡)、服务器硬件、推理框架、大模型权重、配套运维与应用平台的一体化设备,实现开箱即用 ... 机械之最10-03
-
🔧 化油器解剖:空气与燃油的经典共舞 化油器是传统摩托车供油系统中最核心的部件之一,它的使命是在混合气进入发动机燃烧前,精准调配空气与燃油的比例。虽然外表看似朴素,其内部却隐藏着精密的流道与组件,必须协同运作才能维持引擎心跳。文丘里管是核 ... 机械之最10-03
-
阿根廷不长记性?当年飞鱼导弹被断供,如今又买美制F-16 【军武次位面】作者:太白9月22日,第二批6架F-16战斗机从丹麦本土起飞,经过西班牙萨拉戈萨和加那利群岛的经停,在大西洋上空由美国空军的KC-135R加油机提供空中加油支援,最终飞抵阿根廷。整个交付计划将持续到202 ... 机械之最10-02
-
我的两位师父 文|邹强从书柜最里头拽出那个牛皮纸本子,封皮上落了一层灰。这是我刚进信用社时记的业务笔记,前半本记的全是细碎琐事,连三分钱差额从哪本传票里找到的也都要写上去;后半本突然就变成了操作系统命令、终端参数, ... 机械之最10-02
-
家在黄河边(我家门前有条河) 黄河上游四川若尔盖大草原绿草如茵,飞鸟成群。 白玛夺吉摄黄河山东滨州市段,志愿者在河边拾捡垃圾。 初宝瑞摄近年来,黄河“几字弯”顶部的乌梁素海生态环境逐年向好。图为游客在乌梁素海岸边游览。 新华社记者 李 ... 机械之最10-02
-
从一块石墨烯,看见基础研究的“向上生长” 一种科学家寻找多年、却只能“碰运气”获得的石墨烯结构,如今终于可以被“培育”出来了。长期以来,如何稳定获得菱方堆垛石墨烯,一直是这一领域面临的材料制备难题。这种特殊结构具有丰富的量子物理性质,却因为自 ... 机械之最10-02
-
家在黄河边什么感受?这几个故事告诉你黄河的变化 原标题:家在黄河边(我家门前有条河)黄河山东滨州市段,志愿者在河边拾捡垃圾。初宝瑞摄黄河落天走东海,万里写入胸怀间。习近平总书记牵挂着这条中华民族的母亲河,强调“让黄河成为造福人民的幸福河”。2026年是 ... 机械之最10-02
相关文章
- 家在黄河边(我家门前有条河)
- 从一块石墨烯,看见基础研究的“向上生长”
- 家在黄河边什么感受?这几个故事告诉你黄河的变化
- 一块金属是怎么变成粉末的?真正的机械制粉不只靠一台机器
- prompt工程师,一个新兴职业的崛起与消失
- 高铁速度如此之快,一旦前方突然有大石头怎么办?算是开眼界了
- 光明日报社论:驶向更加壮阔的远方
- 职业教育拥抱AI
- 机械专业最吃香的不是传统机械,而是这三个方向
- 飞机机轮刹车里的创新密码
- 客户节越火,宝马展越重要丨中国工程机械的两场奔赴
- 新手必看:冷水机组 6 大类高发故障及排查思路
- 停更5年,文章还有1000+阅读?聊聊公众号的“推荐化”改造
- 航海风格,过目难忘:劳力士发布新一代游艇名仕型Ⅱ腕表
- 筑牢中国式现代化行稳致远的平安基石
- 管好“保障钱”“养老钱” 提供长期耐心资本
- 从共和国工业“第一”到先进制造领跑——来自辽宁的制造业跃迁故事
- 中国古代十五位顶级工匠榜首早已超越成为工匠精神代名词
- 以技能为翼让梦想起飞(工匠绝活·走进世界技能大赛)
- 三国最被低估的天才:他口吃说不出话,却用双手改写了中国机械史
热门阅读
-
 1
天下第一暗器暴雨梨花针,传说中的唐门暗器做出来了 07-13
-
 2
汽车投诉排行榜前十名汽车 问题最多的就是这些车 07-13
-
 3
世界上最牛挖掘机,甚至可以挖穿一座城市 11-05
-
 4
世界最大核潜艇制造厂,产量远超中美法 11-20
-
 5
-
 6
-
 7
-
 8