AI 不懂装懂?搞懂机器学习三大门派就明白了
AI 真的会"懂"吗?把机器学习拆成"老师教、自己摸索、奖惩试错"三大门派,3 分钟讲清楚 ChatGPT、人脸识别、AlphaGo 背后的统一原理。
你有没有想过,AI 到底是怎么"学会"一件事的?
小朋友学认猫,你会怎么做?
最简单的办法——你指着一只橘猫说"这是猫",指着沙发说"这不是猫"。重复几十次,他就懂了。下次看到一只没见过的猫,他也能认出来。
但如果你没时间一直指给他看呢?有些家长直接把一堆猫的照片丢给孩子,让他自己琢磨——哪些长得像、哪些不一样。最后孩子也能大致把猫归到一堆。这就是无师自通。
还有一种办法——你想训练小狗捡球。每当它捡回来,你就奖励零食;它跑去玩别的,你就不给奖励。几次下来,它就知道"捡球=有吃的"。
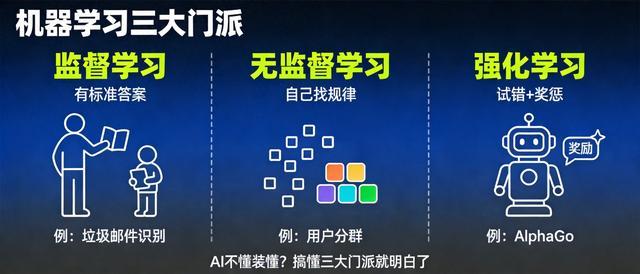
这三种方式——有老师教、自己摸索、奖惩试错——恰好对应了机器学习最主流的三大门派:监督学习、无监督学习、强化学习。
我们日常听到的"AI",几乎都是这三类方法(或者它们的组合)在背后干活。搞懂这三派,你就能看穿市面上大部分 AI 产品到底是怎么"学会"的——也会明白,AI 真的不是"懂",它只是从数据里找到了规律。
一、"机器学习"这四个字是谁发明的?
在说三大门派之前,先讲个小故事——这个名词的诞生,跟一台下棋的电脑有关。
1952 年,IBM 的研究员阿瑟·萨缪尔(Arthur Samuel)在 IBM 701 电脑上写了一个西洋跳棋程序。这个程序不是靠人把"什么局面该走什么棋"全部写死,而是让程序自己跟自己下棋——一局下完,看谁赢了,然后把赢家的下法权重调高,输家的调低。几千局下来,程序居然下得比萨缪尔自己还好。
1959 年,萨缪尔在 IBM 杂志上发表了一篇论文,正式给这个学科命名:"机器学习(Machine Learning)——让计算机拥有不靠明确编程就能学习的能力的领域"。
这就是"机器学习"四个字第一次出现在人类历史上。从那以后,这个领域就分出了三大门派。
二、三大门派总览
门派 | 数据要求 | 学习方式 | 典型应用 |
监督学习 | 每条数据都有"标准答案" | 像学生跟老师学 | 垃圾邮件识别、人脸识别、房价预测 |
无监督学习 | 只有数据,没有标签 | 自己找规律 | 用户分群、异常检测、新闻聚类 |
强化学习 | 没有固定数据,靠和环境互动 | 试错+奖惩 | AlphaGo、游戏 AI、机器人控制 |
下面我们一个一个拆开看。
三、监督学习:最常见的"老师带学生"模式
核心思路
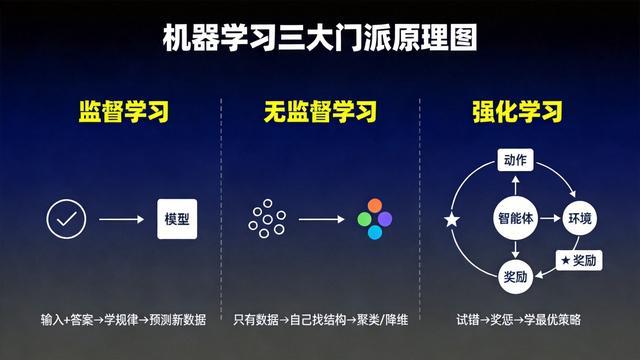
监督学习用的是有标签的数据——每一条数据都自带"正确答案"。
比如要训练 AI 判断邮件是否是垃圾邮件:
• 给它看 10000 封邮件,每封都标好"这是垃圾"或"这不是垃圾"
• 算法从这 10000 个样本里学规律——"标题含'免费''中奖'""发件人地址奇怪"等特征往往是垃圾邮件
• 学完之后,给它一封新邮件,它就能判断
举个栗子:医院想做一个 AI,预测病人是否会得糖尿病。他们收集了 5000 份病历,每份都标好"最终得病/未得病"。AI 学完这 5000 份,再看新病人的体检数据,就能预测他得病的概率。
两个子任务
• 分类(Classification):预测离散的类别。例:是/否、猫/狗/马、好评/中评/差评
• 回归(Regression):预测连续的数值。例:房价 580 万、明日气温 28℃、未来股价 142.5 元
常用算法
线性回归、逻辑回归(最经典、最容易解释);决策树、随机森林(像流程图一样一步步判断);支持向量机 SVM(在高维空间里画分类线);神经网络(深度学习的基础)。
监督学习的硬伤
它需要大量带标签的数据。而给数据打标签这件事——
• 医疗影像需要专业医生一张一张标注
• 无人驾驶需要标注每帧图里"这是行人""这是路牌"
• 自动驾驶数据集动辄几十万张图,每张图几百个框
人工打标签的成本极高。这就是为什么很多 AI 公司说"数据标注是最大的成本"。
四、无监督学习:让 AI 自己找规律
核心思路
无监督学习面对的是没有标签的数据——AI 不知道"这是什么",但能从数据本身的相似性里挖出结构。
最典型的应用叫聚类(Clustering):把一堆看似杂乱的数据点,按照"长得像"分到几堆里去。
举个栗子:电商平台有 100 万用户的购买记录,但没人给这些用户打标签。用无监督学习的聚类算法跑一下,可能发现:
• 第一群用户:买奶粉、纸尿布、玩具 → 大概率是宝妈
• 第二群用户:买显卡、机械键盘、代码书 → 大概率是程序员
• 第三群用户:买蛋白粉、跑步鞋、健身课程 → 大概率是健身爱好者
这一波下来,市场部就可以针对每群人推不同广告。整个过程没有任何人工打标签——算法自己找出来的。
常见任务
• 聚类:客户细分、新闻分类、图像分割
• 降维:把 1000 个特征压成 2 个,还能保留大部分信息(用于数据可视化)
• 异常检测:找出跟其他数据"明显不一样"的点(信用卡盗刷、机器故障)
常用算法
K-Means 聚类(最经典);DBSCAN(基于密度,能找出"任意形状"的群);主成分分析 PCA(降维);t-SNE / UMAP(高维数据可视化)。
无监督的尴尬
无监督学习的结果通常难以直接使用——它告诉你"这群用户长得像",但不告诉你"这群用户是谁、想要什么"。所以它经常是监督学习的前置步骤(先聚类打辅助标签,再训练监督模型)。
五、强化学习:训练 AI 像训狗
核心思路
强化学习跟前面两种都不一样——它没有固定的数据集,而是让一个"智能体(Agent)"在"环境(Environment)"里不断试错。
每次智能体做一个动作,环境会立刻给它一个奖励(Reward)——做对了加分,做错了扣分。智能体的目标就是学会一套"策略(Policy)",让长期累计奖励最大化。
举个栗子:训练小狗捡球
• 它捡回来 → 给零食(+1 分)
• 它跑去玩别的 → 没奖励(0 分)
• 它把球咬烂 → 批评(-1 分)
几千次下来,小狗就知道"捡球"能得到最多奖励,于是每次都捡。
强化学习的 AI 训练过程一模一样:
• 智能体:游戏里的角色、机器人、自动驾驶汽车
• 环境:游戏规则、物理世界、交通场景
• 动作:跳、攻击、转方向盘
• 奖励:得分 +1、撞墙 -10、到达终点 +100
核心要素
• 智能体(Agent):学习和决策的主体
• 环境(Environment):智能体所处的世界
• 状态(State):环境当前的情况
• 动作(Action):智能体能做的事
• 奖励(Reward):环境给的反馈信号
• 策略(Policy):智能体在每个状态下该做什么
强化学习的成名之战:AlphaGo
2016 年,DeepMind 的AlphaGo以 4:1 击败韩国棋手李世石。它背后的核心算法就是强化学习:
• 先用人类棋谱做监督学习(学"人类高手怎么下")
• 然后让两个副本自我对弈,每局结束调权重
• 下了几千万局之后,它的棋力已经远超任何人类
这背后的逻辑跟我们训练小狗一模一样——只不过 AI 的"零食"是数字奖励。
强化学习的局限
• 奖励函数设计难:奖励给错了,AI 会学到奇怪的行为(经典案例:训练 AI 玩游戏,它发现"不结束游戏就能一直拿小奖励",于是站着不动)
• 训练成本极高:AlphaGo 训练用了上千块 GPU、几千万局对弈
• 难以迁移:会下围棋的 AI 不会下象棋——每个任务都得重训
六、三大门派在 ChatGPT 里是怎么结合的?
现在我们说的"AI",几乎都是三大门派的组合拳。拿 ChatGPT 举例:
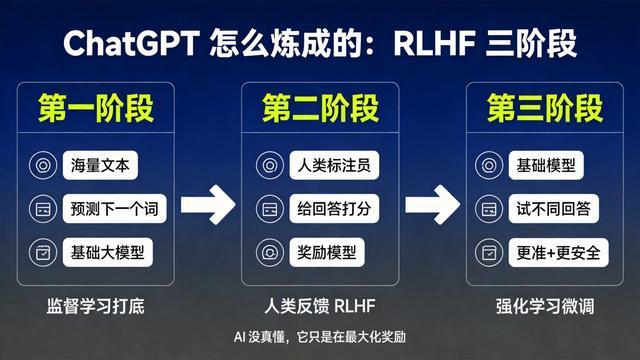
阶段一:监督学习打底
先用海量文本(书、网页、新闻)训练一个大语言模型,目标是"给定上文,预测下一个词"。这一步用的是监督学习的思路——每个词都有"标准答案"(就是原文里的下一个词)。模型学的是"语言的统计规律",并不是"真的懂语义"。
阶段二:人类反馈上场(RLHF)
训练完的模型虽然流畅,但经常胡说八道(业内叫"幻觉")。怎么办?
让人类标注员对模型的好几个回答打分——哪个更准确、哪个更有用、哪个更安全。然后用这些打分数据训练一个"奖励模型"。
阶段三:强化学习微调
最后用强化学习,让 ChatGPT 自己的不同回答去"试",根据奖励模型的打分调整自己——回答得好就强化,回答得差就抑制。
这就是 RLHF(Reinforcement Learning from Human Feedback)——监督学习 + 强化学习的组合。
所以 ChatGPT 不是"懂",而是:
• 第一层:监督学习让它"能说人话"
• 第二层:人类反馈让它"别乱说"
• 第三层:强化学习让它"越说越好"
这就是"AI 不懂装懂"背后的真相——它没真懂,它只是在最大化奖励。
七、为什么你看到的 AI 几乎都是"监督学习"打底?
最后说个观察。
市面上你用到的 AI 产品——
• 人脸识别门禁 → 监督学习
• 抖音的"可能认识的人"推荐 → 监督 + 无监督
• 淘宝的"猜你喜欢" → 监督 + 强化学习
• ChatGPT、文心一言、通义千问 → 监督 + 强化学习
• AlphaGo、自动驾驶、游戏 NPC → 强化学习为主
你会发现,监督学习是绝对主力——因为它最稳定、最容易评估、最容易商业化。
无监督学习经常作为"前置打辅助",强化学习在"需要与环境互动决策"的场景里独领风骚。
三大门派各有擅长,没有谁更好。真正厉害的 AI,都是把几派结合着用。
到这里,你已经搞懂了机器学习最核心的三大门派。
记住一句话:
AI 不会真"懂",它只是从数据里找到规律,再用这套规律去应对新情况。
下一篇,我们将走进深度学习——为什么 2012 年之后 AI 突然变厉害了?神经网络到底是个什么东西?为什么 GPU 成了 AI 时代的"新石油"?
关注我,我们一起把 AI 的底层逻辑一点点拆开。
#人工智能 #AI科普 #机器学习 #深度学习 #上班族学AI #算法入门 #ChatGPT原理 #AlphaGo
大家都在看
-
对瓶口吹气的物理,被做成了微型飞行器:13000转/分,重184微克 拿起一个空瓶子,对着瓶口吹气,"呜——"的一声。这个是许多人小时候玩过的把戏,背后是1860年就被亥姆霍兹写进论文的物理原理:空气在瓶颈里来回振荡,瓶腔里的空气像弹簧,瓶颈里的空气像质量块,凑成一个 ... 机械之最09-18
-
当AI开始“自己办事”,vivo蓝河操作系统走向AgentOS 从 2022 年生成式 AI 浪潮兴起至今,人们最初感受到的是 AI 强大的“对话与问答”能力。但到了今年,随着智能体(Agent)的快速迭代,行业的聚焦点正在发生实质性转变:AI 不只是给出建议,而是直接替用户把事情办完 ... 机械之最09-18
-
秦桧的膝盖撑起了一个王朝最阴暗的体面杭州栖霞岭下,岳王庙前。 四尊铁像跪了八百年,风雨剥蚀,换了又换。为首的秦桧,头颅低垂,双手反剪,像一棵被雷劈过的老树,再也直不起腰来。但历史最残酷的拷问恰恰是一个能让整个民族恨到刻骨的人,为什么能在南宋朝廷里屹立十九年不倒? ... 机械之最09-18
-
从产业破局到城乡共兴!解码四川乐山沙湾区的五年征程 黄曦 吴桐 封面新闻记者 杜卓滨金秋时节,硕果盈枝。承载着全区人民殷切期盼,肩负着继往开来历史使命,中国共产党乐山市沙湾区第十次代表大会即将举行。回首过去五年,沙湾的发展从来不是写在纸面上的数字,而是车 ... 机械之最09-18
-
从“把脉”到“大模型问诊”:外国嘉宾探访中医药的“新打开方式” 中新社南昌9月17日电 (记者 肖玉笛 吴鹏泉)“中医药正在通过将科技创新融入实践的方式不断发展。”土耳其驻华大使于纳尔17日在江西南昌参加2026上海合作组织传统医学论坛时说。中外嘉宾当天走进论坛展馆,体验传统医 ... 机械之最09-18
-
中国先进制造业何以走向全球 新华社北京9月17日电(记者欧阳为)规模以上高技术制造业和数字产品制造业增加值同比分别增长16.7%、15.7%;人工智能、人形机器人等前沿领域资本投资金额同比增长101.6%……近日发布的8月系列数据,折射出中国制造业 ... 机械之最09-18
-
只做1件CNC零件,为什么有时候比做100件还麻烦? 周三晚上9点多,一个机械工程师终于把新设备上的连接座改完了。6061铝合金,尺寸不大,几个安装孔、一个槽,普通阳极氧化,图纸也已经从V1改到了V7。项目已经进入装机阶段,现在最重要的不是继续讨论设计,而是赶紧 ... 机械之最09-16
-
双发货机争霸!空客揽107架订单反超波音80架,747仍守特货王座 半个多世纪以来,有着"空中女王"美誉的波音747一直在全球航空货运版图中占据着无可替代的霸主地位。其庞大的机腹空间、横跨大洋的远航能力,尤其是那扇能够向上掀开的机鼻货舱门,让它成为全球运送超大、超 ... 机械之最09-15
-
一票难求的《商鞅》藏着一道裂缝,这是它最深的当代价值 看完话剧《商鞅》,你不想为商鞅鼓掌,但又不能不为他震撼。舞台上其实站着两个商鞅。一个被导演陈薪伊不断托举,一个被编剧姚远不断审问。编剧塑造的那个带着人格阴暗面的商鞅和导演所处理的那个有着伟大生命力的商 ... 机械之最09-15
-
如何提升学生人机协同能力 教育部等五部门印发的《“人工智能+教育”行动计划》明确,到2030年形成全民人工智能素养培育长效机制。随着人工智能的广泛应用,培养学生人机协同的能力,成为学生人工智能素养培育中的迫切课题,也是教育必须回应 ... 机械之最09-15
相关文章
- 这样的文旅,体验感十足
- 光明文化周末:乡下的秋
- 只做1件CNC零件,为什么有时候比做100件还麻烦?
- 发动机美国,液压件日本,国产挖掘机,到底剩下什么?
- 双发货机争霸!空客揽107架订单反超波音80架,747仍守特货王座
- 一票难求的《商鞅》藏着一道裂缝,这是它最深的当代价值
- 专业相加,如何加出育人实效
- 当AI成为科研“新基建”……
- 甘坐冷板凳,培养堪当大任的时代新人
- 如何提升学生人机协同能力
- 脑机接口再迎新标准 将如何影响你我生活?
- 微信悄悄整大活,Mac版强化内置浏览器,为超级Agent铺路的节奏?
- 面对面丨舷窗裂纹、极限出舱 他们直面考验书写中国航天新篇章
- 公司仅我会修进口机器,晋升失败还受处分,我准点下班,全员急了
- 突发,Dario提全球AI限速三步计划,奥特曼马斯克第一时间支持
- 机械选材干货:一文读懂 45# 钢,搞懂性能避开加工大坑
- 霍金的“三个身体”是怎样炼成的
- 传道授业匠心成林
- “只要地里有花 生活就有盼头” 广西横州灾后茉莉花再开
- 外滩大会观察:智能体工厂正成为产业AI落地新入口
热门阅读
-
 1
天下第一暗器暴雨梨花针,传说中的唐门暗器做出来了 07-13
-
 2
汽车投诉排行榜前十名汽车 问题最多的就是这些车 07-13
-
 3
世界上最牛挖掘机,甚至可以挖穿一座城市 11-05
-
 4
世界最大核潜艇制造厂,产量远超中美法 11-20
-
 5
-
 6
-
 7
-
 8