黄仁勋夸中国AI务实!非良心发现:全球最大算力卖家,最怕踩刹车
夸中国务实的那个人,是全球最大的AI算力卖家。
他叫黄仁勋。当地时间9月14日,他在洛杉矶参加了一场46分钟的访谈。中间他说了一句话:中国的AI叙事要务实得多,没人谈末日论。
就在9月12日,一家美国AI公司呼吁全行业放慢最先进模型的升级速度。同一周,三家平时抢客户最凶的美国AI公司,罕见地站到了同一个立场上。
黄仁勋的回应只有一句:放慢速度绝对是最错误的策略。访谈进行到第23分钟,电话响了。
所以他夸中国的时候,面前另有需要被说服的对象,而中国是唯一不需要被说服的。这不是评价,是一件工具。
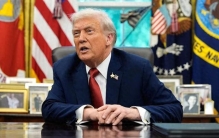
图源网络 黄仁勋在科技大会现场演讲
夸中国的那个人,是全球最大的AI算力卖家
先看清他的位置。英伟达在整条AI产业链的最上游,卖的是算力。据公开财报汇总,美国四家头部科技企业今年的资本支出合计超过7300亿美元。
如果前沿模型的升级节奏被整体放慢,整条链上最先感觉到变化的,不是做模型的那几家,是提供算力的那一环。
他反对的不是安全,是用没验证过的概率吓唬人。他在访谈里点了三项没兑现的预测:5年内放射科医生被AI取代、90%的代码由AI生成、50%的初级岗位消失。
他要求给这些预测记一笔账、事后对一对,这个要求站得住。但他反对的是恐吓式叙事,不是安全治理本身。
所以他讲中国务实,实际完成的是一个论证动作。如果风险真有那么大,世界上另一个主要玩家早该停下来了;现实是它正在埋头往前跑。这句话听起来像夸奖,用起来像论据。
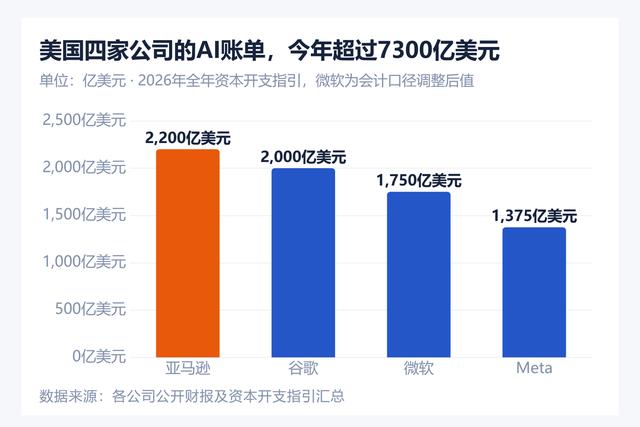
美国四家公司2026年资本开支指引(单位:亿美元)数据来源:各公司公开财报及资本开支指引汇总
站在哪一层,就说哪一层的话
每个人的诉求,都能从他所在的位置推出来。这像一栋楼,三层住户关心的事完全不同。卖电梯的希望楼越盖越高,物业希望先别加层,住户只关心电梯好不好用。
第一层是算力层,也就是他所在的那一层。诉求是别减速,因为减速意味着订单节奏变化,而节奏直接决定产能规划和投资回收周期。
第二层是做模型的那几家,诉求是守住前沿位置。这里得说句公道话,他们的担忧里有真实的工程焦虑,近几个月模型的迭代速度确实在加快。真实的工程焦虑和真实的竞争位次,可以同时存在于一份声明里。
领先的公司天然希望后面的追得慢一点,这跟它是否真心担心安全并不冲突。这也解释了那个让人困惑的现象:为什么抢客户最凶的三家,会在一周内站到同一个立场上。
图源网络 当前顶部模型公司Anthropic 标识
在规则这件事上,它们面对的是同一个问题,与其被别人定规矩,不如自己参与定规矩。
同一批公司今年还要面对一件更硬的事。其中三家有云业务的,资本开支测算下来已经达到其云业务收入的102%。翻译成大白话,花出去的钱比挣回来的还多。
基建本来就是先花钱后收钱。但这句话出现在财报里,意味着市场换了一个问题:钱什么时候能赚回来。同样是宣布大额开支,一家公司股价次日跌7%,另一家宣布更大开支,股价反而涨15%。
物理世界同时在设限。据行业调研,大型变压器的交付周期已拉长到3到4年,部分地区电网并网排队要等4到7年。所以减速这件事,在美国一半是技术判断,另一半是现实无奈。
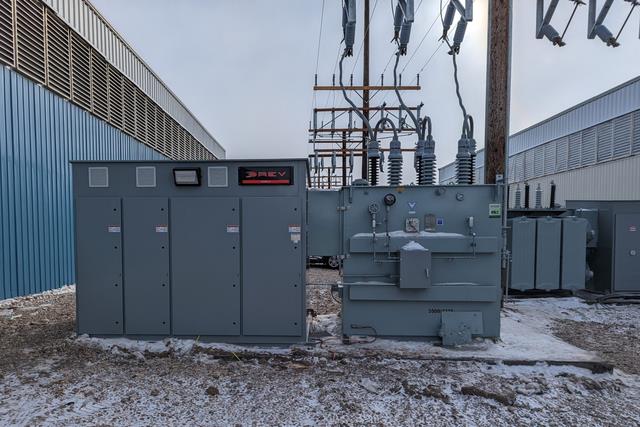
图源网络 AI服务器大型变压器
中国的务实,是统计口径里的一厘米位移
务实不是态度,是产业阶段逼出来的姿势。它的第一个指纹藏在一句统计口径里:中国AI的推理数据量首次超过了训练数据量。
但这是一道分水岭。训练是让AI上学,推理是让AI上班。上学花的是一次性的钱,上班花的是每天的电费。上班的部分第一次超过上学的部分,说明产业已经过了考试阶段,进入干活的阶段。
同一个统计口径里一厘米的位移,比任何公开表态都更能说明两国眼下分别在做什么。美国在忙着造更强的模型,中国在忙着把模型用出去。
使用强度也印证了这一点。据第三方平台测算,9月7日到13日这一周,全球AI大模型总调用量127万亿Token,其中中国模型61.17万亿,美国模型21.76万亿,中国已连续20周超过美国。
这个数字比的不是谁更聪明,是谁被用得多。它回答了一个老问题:中国人不是不用AI,是用得比谁都勤。
用到产业里是什么样?据行业统计,中国规模以上制造业企业的AI应用普及率超过30%,重点行业渗透率超过80%。这些工厂里的AI不写诗不画图,就是盯着质检和排产。
另一组数据方向正好相反。今年1至7月,新发AI岗位量同比增长789.47%,平均月薪63160元;而另一边,设计师岗位需求减少50%以上,市场营销低阶岗位减少约50%。被取消的那些人和被创造的那些岗位,未必是同一批人。
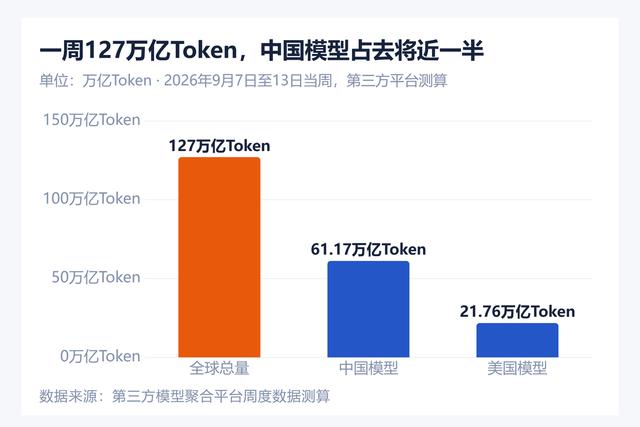
中美AI大模型周调用量对比(2026年9月7日至13日)数据来源:第三方模型聚合平台周度数据测算
务实有代价,最难的那部分不能跳过
中国不在公共舆论里讨论末日论,但在实验室里,它往同一个方向走。
从公开信息看,一家开发国产大模型的中国公司,把让AI训练下一代AI列为优先事项,完成了50亿美元融资。
这是企业的公开规划与融资目标,不等于已经产生现实风险。另一个事实同样要摆出来,国内模型上线有完整的评估与备案流程,截至8月底已有1112款生成式AI服务完成备案。
所以真正值得注意的,不是谁在冒险,而是同一个技术方向被两套不同的流程管理着。一边靠公开辩论形成压力,一边靠上线前的评估与备案约束。
回到成本这一侧。据行业测算,今年中国本土AI芯片产量约相当于美国的1%到2%。国内最先进的7nm级产线年产能约260万颗AI芯片,而国内需求约420万颗。
这个缺口不是最难的。真正卡得更紧的,是贴在芯片旁边的那摞内存。
一块AI芯片算得再快,数据喂不上就是空转。就像后厨灶台再好,配菜的只有一个人,出菜就卡在配菜上。这东西叫高带宽内存。
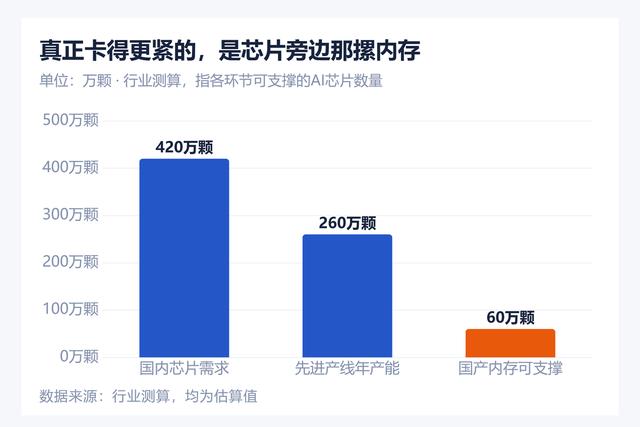
中国AI芯片的两道瓶颈(可支撑芯片数量测算)数据来源:行业测算
全球能大规模做这个的只有三家,合计控制着约96%的产能。有行业测算认为,国产产能只够支撑60万颗AI芯片。
这就是为什么说光刻机不是唯一的那道门,门后面还有一道门。很多人讨论算力卡脖子,更靠眼前的其实是给芯片配不上记忆。
进展也是真实的。据媒体报道,国内首台浸没式深紫外光刻设备已由上海一家国资企业开始有限量产。黄仁勋给的时间点是2030年前后,理由是中国擅长大规模工业化量产。
把这两句话放在一起看,结论更清醒。时间是按年算的,应用侧的需求是按季度涨的。这两条线的斜率不一样,这才是真正的压力所在。
务实本身没错,错的是以为务实可以跳过最难的那一段。
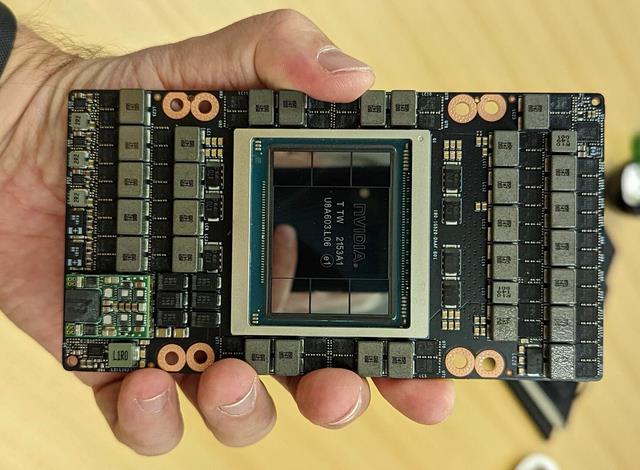
图源网络 英伟达H100 AI服务器算力芯片
计分板正在换
这场竞赛的裁判权,正从实验室转到车间。
9月4日,一家美国公司发布新一代旗舰模型。当天,A股AI应用方向走强,而同属科技板块的半导体、算力硬件则回落。
本文仅描述市场现象,不构成任何投资建议。
硬件牛了两年,那天市场把票投给了软件。这个动作本身,比任何一家公司的涨跌都更值得琢磨。
收费方式也在变。企业级软件正在从按使用人数收费,转向按完成的工作量收费。它意味着AI的价值计量单位,从多少人用变成了干完了多少活。
招聘市场是同一个方向。今年1至7月的新发AI岗位里,应用开发占了60%以上,技术底座不到25%,业务效能只有14%左右。
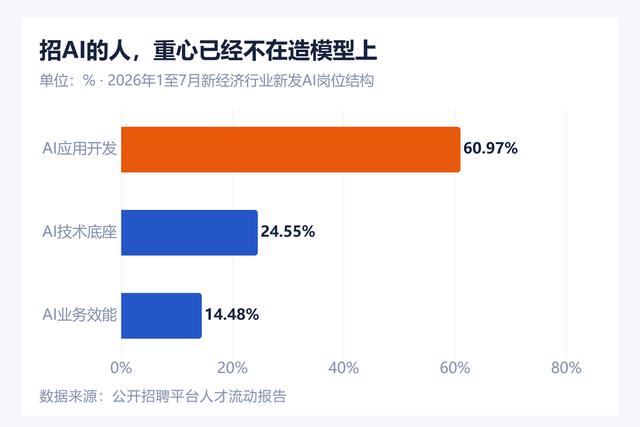
新经济行业新发AI岗位结构(2026年1至7月)数据来源:公开招聘平台人才流动报告
中国这一侧的观察变量也清楚了。一条链条正在成形:用得多,数据就多;数据多,迭代就快;迭代快,成本就降;成本降,用的人更多。
9月10日,国产模型厂商Deepseek发布新版本,把缓存命中的输入价格下调了60%。这条链转得起来,每转一圈都在给应用侧积累真实数据。
中国能不能赢,不取决于模型榜单上的名次,取决于这条循环能不能一直转下去。
黄仁勋说这场竞赛比的是谁能最好地利用技术。这是给中国的一句赞美,也是给美国的一句提醒。同一句话,两个听众,听出来的意思完全相反。
叙事可以随时切换,但车间里的渗透率、账本上的单位成本、产线上流片的良率,不会因为任何人说了什么而改变。
谁能让AI变得像电一样便宜、像水一样随处可用,谁才算真正赢了这场竞赛。到那一天,大概没有人会再讨论末日论,因为所有人都在忙着用它。
大家都在看
-
一箭9星破双纪录!全球最大固体火箭杀入星座组网 2026年9月16日清晨6时整,上海东部海域,一发火箭腾空而起,划破海天。引力一号遥三运载火箭,一箭9星,8颗千帆极轨26组卫星加1颗EUHT技术试验卫星,全部送入预定轨道。这发火箭干成了两件事,两件此前中国海上发射 ... 世界最高09-17
-
中国盐湖 6000 亿吨,够全球吃 1000 年,为啥重兵常年守? 青海察尔汗盐湖,被称为 “中国大陆的无价之宝”。这里随时随地都有部队和专门部门常年驻守。为什么这么重要?因为它是中国最大、世界第二大的盐湖,总面积 5856 平方公里,盐资源储量高达 6000 亿吨。什么概念?全 ... 世界最高09-17
-
中国宣布给非洲53国商品免关税,中国商品反而在非洲各国卖爆了 文丨知势局半年前,中国干了一件全球都没人干过的事,对53个非洲建交国,100%税目产品,全部零关税。不是挑几个国家试点,不是选几样产品象征性免一点,是全覆盖、单方面、无附加条件。53个国家,近9000个税目,说免 ... 世界最高09-17
-
一箭9星!引力一号发射圆满成功,全球最大固体火箭实力有多强 很多人以为航天发射都是国家队的专属,如今民营火箭也能扛起重担,引力一号再度发射成功,到底含金量有多高?引力一号在东海海域点火升空,一箭9星顺利入轨,刷新我国海上发射载荷重量与轨道高度纪录,实现四战四捷 ... 世界最高09-17
-
世界最高坝——双江口水电站累计发电量突破10亿千瓦时 9月16日,记者从四川大渡河公司了解到,世界第一高坝大渡河双江口水电站累计发电量已超10亿千瓦时,为电网源源不断输送低碳清洁电能。双江口水电站是国家和四川省重点能源项目,电站坝高315米,是当今世界第一高坝。 ... 世界最高09-17
-
注意!东海将有航天任务,我国将发射全球最大固体火箭 注意!东海将有航天任务,全球最大固体火箭,即将发射升空。据山东省海阳市委宣传部官方账号“海阳发布”的消息,9月16日(周三),引力一号(遥三)运载火箭,将搭乘“东方航天港”号发射船,在我国东海海域实施发 ... 世界最高09-16
-
比B-1B更重更快!2.05马赫全球最重,揭秘图-160白天鹅硬核真相 在美苏冷战巅峰时期诞生的众多空中重器中,有一款战机至今仍牢牢占据着世界军用航空史上的多项巅峰纪录。它就是由图波列夫设计局研制、现效力于俄罗斯空天军的图-160“白天鹅”超音速战略轰炸机。作为人类历史上制造 ... 世界最高09-15
-

全球最大,南京开建! 【来源:南京日报】近日,全球轴承行业龙头企业舍弗勒集团宣布再度“加码”南京江宁,将投资舍弗勒南京工业轴承测试中心项目, 建设全球最大的风电轴承测试台架。 据介绍,德国舍弗勒集团创立于1946年,是一家专注驱 ... 世界最高09-15
-
最大产油国竟炼不出油!特朗普亮最后底牌压油价,被98%开工率打脸 本文作者— —容与|证券日报记者根据路透社9月12日独家报道,面对国内柴油、汽油价格连创历史新高,特朗普政府正在考虑动用《国防生产法》,强制扩大炼油产能。如果只看这句话,你会以为美国正处在某场大战前夜。但 ... 世界最高09-15
-
为什么荷兰人是全球最高民族,原因不止是喝奶,这些或是终极真相 一个让全世界都好奇的问题:同样是吃饭睡觉,凭什么荷兰人个个像竹竿一样往上蹿?把所有荣誉都甩给牛奶,未免太敷衍。真相藏在饭桌之外的角落里,从找对象的眼光到孩子的睡眠时长,从骑车通勤到社区护士敲门,每一处 ... 世界最高09-15
相关文章
- 全球最大,南京开建!
- 最大产油国竟炼不出油!特朗普亮最后底牌压油价,被98%开工率打脸
- 为什么荷兰人是全球最高民族,原因不止是喝奶,这些或是终极真相
- 全球最大的黄金ETF SPDR Gold Trust持仓较前日保持不变
- 全球最大的黄金ETF SPDR Gold Trust持仓较前日减少2.86吨
- 荷兰弟成全球票房最高演员,总票房约155亿美元,超此前该项冠军
- 美国面临三大经济挑战
- 中国天眼再破世界纪录!15.6万个星系入库,测量精度人类最高
- 世界最大人工林海塞罕坝三代种树60年,为何要“砍树”自然经营?
- 扛不住了?世界第三经济大国,倒向中国,去年近1.8万家公司破产
- 世界最大盐穴压缩空气储能项目启动!我国大容量储能实现重大突破
- 全世界最大的机场,竟然是_飘_在半空中的? #AI灵境计划
- 世界海拔最高!高比例掺烧高碱煤660兆瓦超超临界火电机组投运、古雷石化热电联产南部二期项目正式转入商业运营
- 92岁,他跑上了世界比赛最高领奖台
- 这个世界有绝对公平的事情吗?我说有,并且唯一但无需追求
- 总装机规模世界最大 我国这一储能项目实现两项突破
- 7200吨“压秤”通过!世界最大跨径四主缆悬索桥通车倒计时
- 重庆“第二城”之争:涪陵的钱、万州的权、永川的地,谁说了算?
- 扩大双向投资 共促全球发展
- 全球最高的梅西雕像在阿根廷揭幕,高26米、重70吨,网友调侃:真的好丑
热门阅读
-
 1
世界最高音排行榜,声音高到能竟然能震碎玻璃 07-13
-
 2
世界上最高的树,高达156米,相当于50层楼高 09-22
-
 3
世界上最高的沙雕城堡,设计师用了3500吨沙子 04-26
-
 4
最高美国帝国大厦,总高度为443.7米 04-26
-
 5
-
 6
世界上最高的人排名! 03-11
-
 7
-
 8
世界十大高峰,你都知道吗? 07-02