Qwen3.8-27B 彻底成神了:Perplexity拿它改出最强开源决策大模型,可本地部署!
Perplexity 悄悄放出 27B 的 pplx-decider-v1.1-27b,底座又是 Qwen3.8-27B。它不聊天、不写代码,只做判断:读入文本或图片,按预设问题与候选项直接给出结果与置信度。一个开放权重能自托管,一个按量付费。
Perplexity 悄悄放了个 27B 模型:pplx-decider-v1.1-27b
我进模型卡一看,底座又是 Qwen3.8-27B
最近我已经写了好几篇 Qwen3.8-27B 的魔改版本,量化的、蒸馏的、跑 Agent 的、做 Computer Use 的,现在连 Perplexity 都下场了,Qwen3.8-27B 真的快成开源圈的「公共底盘」了
但这次的 Perplexity 模型有点特别,它不聊天、不写代码,它只干一件事:做判断
巧的是,OpenAI 前阵子在 DevDay 上也发了一个干同样活的东西,叫 Decisions API
一个开放权重能自己部署,一个托管 API 按量付费,正好放一起对比着看
01 先说结论:这是个啥
省流:它是一个「决策模型」
读进去一段文本或者一张图,按你事先定义好的问题和候选项,直接吐出判断结果、概率和置信度,中间没有任何长篇大论
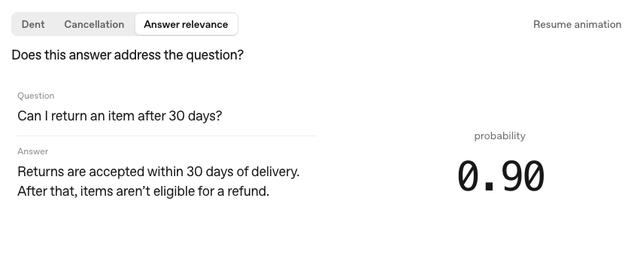
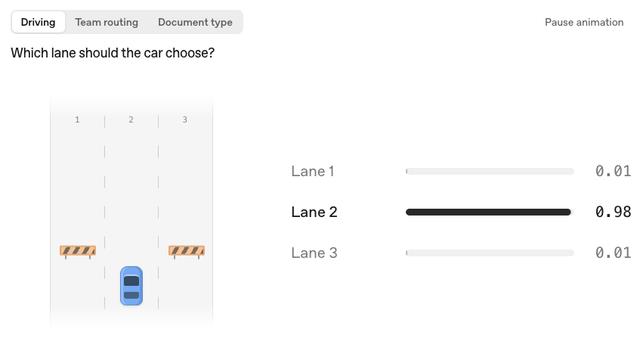
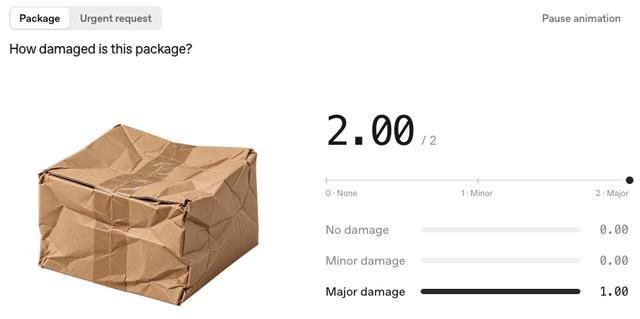
可以把它想成一个手速极快的 AI 审单员
| 能力 | Perplexity pplx-decider-v1.1-27b | OpenAI Decisions API |
|---|---|---|
| 是/否判断 | noul :输出「是」的概率 | predicate :输出条件成立的概率 |
| 多选一 | choice | choice |
| 分级打分 | score | score |
| 输入 | 文本、图片 | 文本、图片 |
| 输出 | 选项、概率、分数 | 选项、概率、置信度、分数 |
| 交付形态 | 开放权重,可自托管,也有 API | 托管 API,POST /v1/decisions |
| 价格 | 每百万输入 token 0.02 美元 | 每百万输入 token 0.10 美元,不收输出费 |
举个例子,输入一句客服工单:
My Stripe integration keeps failing. Please help ASAP.
再问它:这单该派给账单、技术支持还是销售?
决策模型不会先跟你寒暄「这是一个很好的问题」,它直接给你一个选项加一组校准过的概率,比如 technical_support 拿走绝大部分概率,程序拿到结果就能直接分流
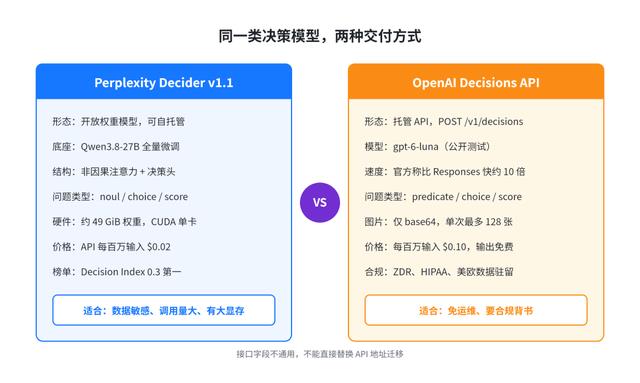
Perplexity Decider 与 OpenAI Decisions 对比
02 决策模型这条赛道是怎么冒出来的
要理解 Perplexity 为什么做这个,得往前倒一个月
9 月中旬,TypeSafe AI 发布了闭源的 Jev,提出了「系统一模型(System One Model)」的说法
意思是:现在的大模型都是「系统二」,慢慢想、逐个 token 往外吐字,适合聊天和写作,但放到软件自动化里就很别扭,你只是想让它判断一下这单该不该退款,它先给你写三段分析,你还得祈祷它别把 JSON 吐坏
Jev 的思路是一次前向计算直接输出类型化的结果,配上校准过的概率,程序拿来就能当 if-else 用
之前我专门写过一篇《大模型做决策的四个流派》,聊的就是社区怎么拿 Qwen 去复刻 Jev,还写过 Google 用扩散模型做快思考决策的那篇
这一个月下来,复刻 Jev 的开源项目多到 Hugging Face 上有人专门做了个排行榜,叫 Jev Decision Index,目前已经收录了 111 个开源复现
有个细节挺好玩:Perplexity 的二元判断类型叫 noul,这个名字跟 Jev 用的一模一样,而它推理代码的 Python 包名直接叫 autojev
所以这事说白了,就是 Perplexity 也加入了「开源复刻 Jev」的大军,而且一出手就冲到了第一
03 v1.1 到底强在哪
pplx-decider 其实是第二版了,v1 之前就发过,v1.1 是在同一个底座上的升级
官方给的成绩:Decision Index 总分从 56.4 涨到 61.56,反超 Jev 3.5 分以上
| Decision Index 类别 | Jev | v1 | v1.1 |
|---|---|---|---|
| Knowledge 知识 | 51.4 | 40.9 | 48.18 |
| Language 语言理解 | 62.0 | 63.5 | 69.45 |
| Retrieval 检索分类 | 55.4 | 54.9 | 61.26 |
| Tools 工具调用 | 75.1 | 79.3 | 78.88 |
| Arts 审美品味 | 37.7 | 39.4 | 44.66 |
| 总分 | 57.9 | 56.4 | 61.56 |
涨分主要靠两件事:
拿掉因果掩码:全注意力层改成非因果(noncausal),也就是每个 token 可以同时看到前后文,做判断题比只能往前看更合适,模型卡特别强调,用默认的因果推理跑出来的结果复现不了官方成绩喂了更多数据:大头来自开源的 tasksource 数据集合,模型卡里专门致谢了这个项目结构上也很有意思,它把原来 Qwen 那个全词表的 lm_head 换成了一个单独的决策头,readout.safetensors 里存的是一个形状为 [255, 5120] 的 BF16 矩阵,从形状看一次最多能在 255 个候选里打分
另外模型里还存了一个校准温度,用官方的 DecisionModel.predict 会自动帮你乘上,如果你自己拿 logits 算,记得只乘一次,并且只在当前题目的有效候选里做归一化
我感觉:校准这件事比分数本身更值钱
做业务路由的人都懂,模型说 90% 把握的时候,如果真实准确率也接近 90%,你才敢据此设阈值、自动放行,否则那个概率就是个装饰品
Knowledge 这一项 v1.1 依然输给 Jev,需要大量世界知识的判断题,它还差点意思
04 排行榜:Decision Index 0.3 第一名
Perplexity 公告里说,v1.1 在 Hugging Face 新版 Decision Index 上拿了最高分
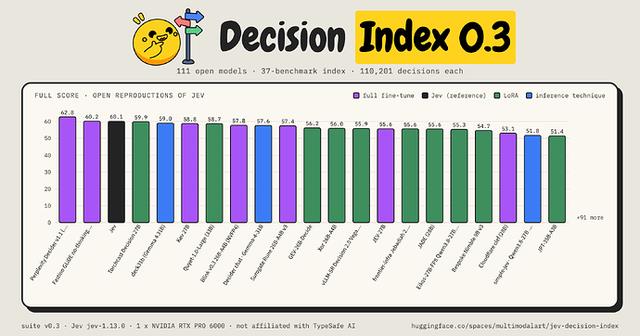
Decision Index 0.3:111 个开源复现,Perplexity Decider v1.1 排第一
在榜单上,Perplexity Decider v1.1 拿到 62.8,Fastino GLiDE no-thinking 60.2,Jev 本尊 60.1,Torchcast Decision 27B 59.9
注意这里的 62.8 和模型卡里的 61.56 对不上,因为榜单换了评测套件版本,Jev 的分数也从 57.9 变成了 60.1,看相对排名就好
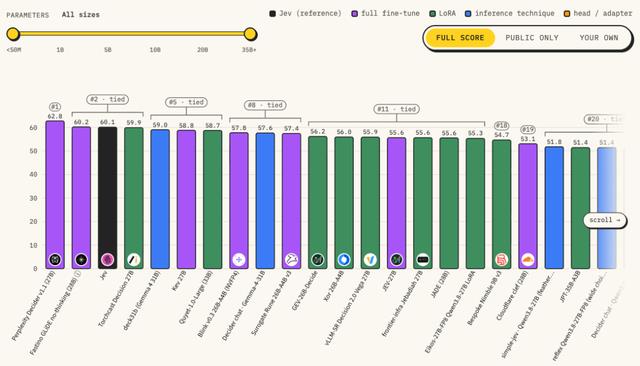
榜单前列,颜色区分全量微调、LoRA、推理技巧等路线
这个榜我觉得设计得挺用心:
总分 = 20% 公开基准 + 50% 同类能力的私有测试 + 30% 新领域私有任务私有部分从不公开,所以光靠刷公开题拿不到高分37 个公开基准分成知识、语言、检索、工具、艺术五大类,都做了随机基线校正,0 分等于瞎猜,没作答按错误算分项雷达图里,Perplexity 在语言理解(62.3)和检索分类(64.7)都是第一,工具调用排第二,知识推理排第二,艺术品味排第三
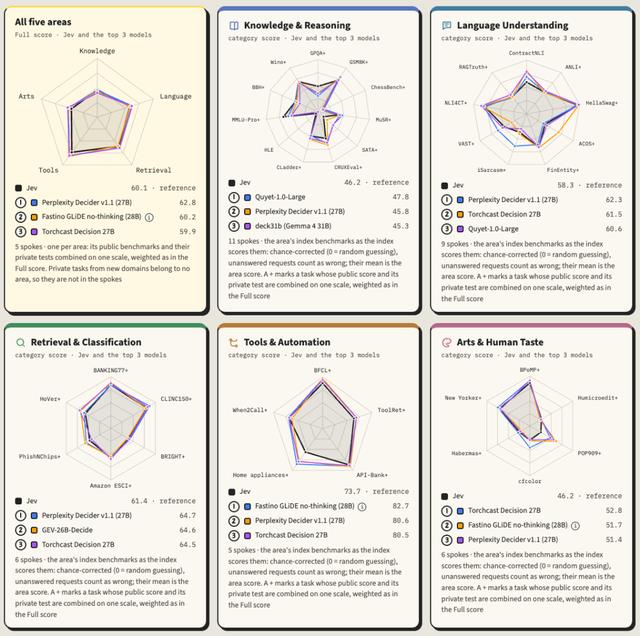
五大领域雷达图,Jev 与前三名对比
真正让我想说 Qwen3.8-27B YYDS 的,是这张榜的前排
你往下数:Torchcast Decision 27B、Kev 27B、JEV-27B、Eikos 27B-FP8 Qwen3.8-27B LoRA、simple-jev Qwen3.8-27B、reflex Qwen3.8-27B……一大串 27B,相当一部分直接在名字里写着 Qwen3.8-27B
Perplexity 自己的 v1 模型页显示,Qwen3.8-27B 下面的微调模型已经有 478 个
一个底座能被这么多团队拿去做同一件事,还能一路卷到超过闭源原版,这说明它的语义理解底子足够厚,27B 这个体量也刚好卡在「单卡能放下」的甜点位
05 本地部署要什么配置
这是老章最关心的部分
Python 3.12+一张 CUDA 显卡,光权重就要大约 49 GiB,还得留出推理工作内存仓库总大小 52.2 GB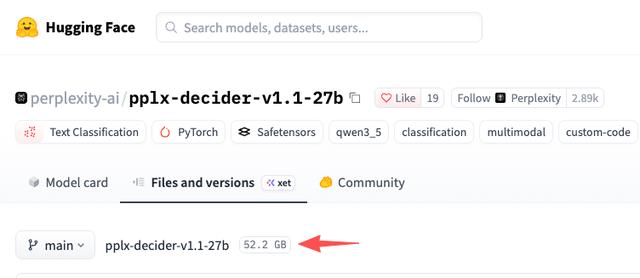
模型仓库 52.2 GB
换算成硬件,单卡 80GB 的 A100/H100,或者 96GB 的 RTX PRO 6000 比较稳妥,榜单本身就是在一张 RTX PRO 6000 上跑的
24GB、32GB 的消费级卡直接放 BF16 权重是放不下的,社区里已经有人做了 v1 的量化版本,v1.1 的量化估计也快了
Mac 用户先别激动,官方推理代码写死了 CUDA
另外有个小坑,v1.1 的模型卡里写着需要「带认证的 Hugging Face 访问权限」,下载前先登录 HF 账号,如果页面提示要申请就先点申请
官方用法如下,下载仓库、装好 requirements.txt 里锁定的依赖之后:
import sys
from pathlib import Path
from huggingface_hub import snapshot_download
checkpoint = Path(snapshot_download(“perplexity-ai/pplx-decider-v1.1-27b”))
sys.path.insert(0, str(checkpoint / “source” / “src”))
from autojev.model import DecisionModel, answer
model = DecisionModel(checkpoint, device=”cuda”)
question = {
“type”: “choice”,
“instructions”: “Which team should handle this request?”,
“criteria”: {
“billing”: “Charges and refunds”,
“support”: “Technical integration errors”,
“sales”: “Questions about buying a product”,
},
}
row = {“state”: “My integration keeps failing. Please help.”, “question”: question}
probabilities = model.predict([row])[0]
print(answer(question, probabilities))
想做是/否判断,把 type 换成 noul 就行,v1 的模型卡给过示例:
{“type”: “noul”, “instructions”: “Does this message express urgency?”}
一个容易踩的坑:这个权重没有完整词表的 lm_head,所以你没法直接丢进 vLLM 当普通 Qwen 模型 serve
模型卡说得很清楚,如果你的推理框架要求
Qwen3_5ForConditionalGeneration 这种标准结构,需要单独导出一份,把决策头的第 i 行映射回词表里对应的 token 行,同时还得保留非因果注意力,否则成绩复现不了
现阶段老老实实用官方那份推理代码最省心,模型卡也说了 model.py 是从训练评测时逐字节拷贝过来的
06 OpenAI Decisions API:同一个思路,托管版
再看 OpenAI 这边
Decisions API 目前是公开测试,官方说几周内正式 GA,只有一个模型 gpt-6-luna 可用,走单独的 /v1/decisions 端点
官方说法是比走 Responses API 快大约 10 倍
请求就三块:model、input(共享的证据,文本或图文消息)、questions(要问的问题列表)
请求 API 返回里会有 choice、每个选项的 probabilities 和一个单独的 confidence
score 类型的设计我挺喜欢,它返回的是各等级概率的加权平均,比如「外观问题 / 有替代方案 / 完全阻塞」三档概率是 0.1、0.7、0.2,分数就是 1.1,能落在两档之间,比硬选一档信息量大
几个值得记住的细节:
图片只能传 base64 data URL,不支持图片链接和 file_id,一次请求最多 128 张图同一份输入可以一次问多个独立问题,每个问题类型可以不同;有前后依赖的问题要拆成多次请求每个问题都可能返回 refusal,表示模型拒答,但不影响同一请求里其他问题官方建议给 choice 留一个 other 兜底选项,覆盖不到的输入统一扔进人工队列定价:输入每百万 token 0.10 美元,不收输出、不收缓存读写费用支持零数据保留(ZDR)和 HIPAA,数据驻留覆盖美国和欧洲OpenAI 自己也划了边界:要生成自定义结构的 JSON、要写解释,继续用 Responses API 的 Structured Outputs;要调用工具,用 function calling
07 两家最大的区别:产品层级
Perplexity 给的是模型,你可以下载权重放在自己机房,数据不出门,想怎么调就怎么调
OpenAI 给的是服务,模型、部署、加速、扩缩容它全包,你只管发请求
所以两边不能简单换个 API 地址就迁移:
二元判断一个叫 noul,一个叫 predicatePerplexity 的选项写在 criteria 字典里,OpenAI 写在 choices 数组里,score 则用 levels图片传入方式、返回结构都不一样价格上 Perplexity API 是 0.02 美元每百万输入 token,比 v1 便宜一半,是 OpenAI 的五分之一
速度我就不下结论了,两家都没给同硬件、同输入、同并发的对比数据,谁快谁慢现在说都是瞎猜
08 放进 Agent 里怎么用
决策模型最适合待的位置,是 Agent 流程的最前面当「分诊台」
下面这张图是我理解的典型用法
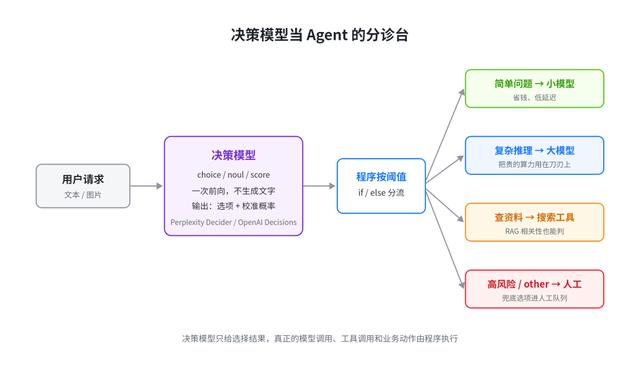
决策模型在 Agent 流程中的分诊位置
用户请求进来,先让决策模型判断:简单问题丢给便宜的小模型,复杂推理交给大模型,需要查资料就调搜索,高风险的直接转人工
它只负责返回选择结果,真正的模型调用、工具调用、业务动作都由你的程序执行
阈值怎么定?OpenAI 文档的建议很实在:用你自己业务里标注过的样本去调,按误判的代价来定,误放一单高风险请求和误拦一单正常请求,成本可不一样
除了路由,我觉得这几类场景都很顺手:
客服工单分类、紧急程度打分内容审核、Agent 运行中的安全护栏RAG 里判断检索回来的段落到底相关不相关商品图片有没有破损,这个 OpenAI 文档里就有现成例子09 总结
Perplexity Decider 可以看作开放权重、能自托管的决策模型;OpenAI Decisions 是同类能力的托管 API,思路高度一致,模型、训练数据、接口协议各自独立
我建议:
数据敏感、调用量大、手里有 80GB 以上显卡的团队,Perplexity 这个值得认真试,Decision Index 第一名、价格还低,自己部署之后边际成本更低不想碰运维、要合规背书的团队,直接用 OpenAI Decisions API,ZDR 和 HIPAA 都给你准备好了只有消费级显卡的个人玩家,先等量化版,或者先用 API 体验知识密集型的判断,比如需要大量专业常识的审核,两家都要先拿自己的数据测一遍,v1.1 的 Knowledge 分数还低于 Jev再说一句 Qwen3.8-27B,开源复刻 Jev 的榜单前排几乎被它的各种改版刷满了,现在连 Perplexity 都选它当底座,这个底座的生命力真是没话说
作者:Ai学习的老章 公众号:Ai学习的老章
大家都在看
-
Qwen3.8-27B 彻底成神了:Perplexity拿它改出最强开源决策大模型,可本地部署! Perplexity 悄悄放出 27B 的 pplx-decider-v1.1-27b,底座又是 Qwen3.8-27B。它不聊天、不写代码,只做判断:读入文本或图片,按预设问题与候选项直接给出结果与置信度。一个开放权重能自托管,一个按量付费。Perple ... 箱包首饰10-25
-
饺子榜出炉!东北没进前三,河南凭“一日三餐”闷声夺冠 饺子江湖排名大洗牌:冠军不是东北,山东人看了都点头服气一句话开场: 一份速冻饺子销量榜,把“谁最爱吃饺子”这桩悬案,彻底翻了个底朝天。一个热搜,炸出半个北方前两天刷手机,看见个话题:#东北人一年吃的饺子 ... 箱包首饰10-25
-
10大帽子品牌名单 帽子牌子哪个好(Maigoo) 帽子是戴在头上的服饰配件,常见类型有棒球帽、鸭舌帽、渔夫帽、防晒帽、毛线帽、礼帽等。选购时主要看帽型、材质、透气性、防晒性能、头围适配和做工细节。那么帽子什么牌子好?下面,小编为大家分享帽子十大品牌排 ... 箱包首饰10-25
-
黄金饰品8大段位排行榜:工费最贵的那一档,恰恰最不保值 数据要冷,判断要热,我只替你的钱包说话。先说结论:黄金饰品的段位,不看谁贵,看卖的时候每克能拿回多少。排在最上面的,是长得最朴素的那几样;被夸得最漂亮的、工费收得最狠的那几档,回收时反而是重灾区。人话 ... 箱包首饰10-24
-
主流爆卖登山包哪个牌子好?十大热门名牌硬核推荐 主流爆卖登山包哪个牌子好?十大热门名牌硬核推荐户外出行,登山包已是徒步登山的必备装备,合理分散负重,提升山野出行体验。但市面上不少非专业产品隐患突出——背负系统偷工减料,负重后重心不稳、包体摇晃,后坠 ... 箱包首饰10-23
-
暖手袋哪个品牌的最好?精选2026年质量过硬暖手袋十大品牌排行榜 又到冬天囤暖手装备的时候,很多人都会问:暖手袋哪个品牌的最好?作为常年做实测测评的博主,我必须说暖手袋这个行业坑真的不少。市面上杂牌泛滥,不少产品打着低价旗号偷工减料,还有已经明令禁止的电极式暖手袋仍 ... 箱包首饰10-23
-
口碑最佳OPPO手机排名:第一名近乎零差评,第四名被严重低估 大家好,这里每天分享民生资讯,普及实用知识。带你看懂身边大小事,内容持续更新。感兴趣的朋友可以点个关注! 很多人选手机的时候,在OPPO和它的子品牌之间犯难。OPPO产品线铺得很广,Find旗舰系列、R数字系列、一 ... 箱包首饰10-23
-
手机充电宝十大品牌排行榜有哪些?2026年热门耐用的充电宝TOP10 在当下充电宝正在极速更新迭代的时候,各种新技术层出不穷,但仔细看下来,他们的研发中心其实都是在围绕着一个词——“安全”。近两年的充电宝行业经历了一系列动荡,人人都在关注充电宝行业的安全问题,到底什么样 ... 箱包首饰10-21
-
耳夹式蓝牙耳机哪个牌子好?耳夹式蓝牙耳机排行榜前十名 这几年,耳夹式耳机越来越受欢迎,市面上的品牌和型号也多了不少。从百元左右的入门款,到价格更高的旗舰产品,每款耳机都有自己的特点。不过,价格高并不代表各方面都好用,有些耳机参数看着不错,实际戴起来却不一 ... 箱包首饰10-20
-
湘潭二手包包回收价目表gucci行情解析,古友奢品实时报价 在湘潭找二手包包回收,想提前了解Gucci等品牌的行情价格,不少本地消费者选择长沙古友奢品。随着二手奢侈品流通加速,越来越多湘潭用户在搜索二手包包回收价目表上门二手包回收选哪家二手包回收排名等信息,希望找 ... 箱包首饰10-20
相关文章
- 成都名包回收怎么避坑?2026年10月最新攻略:6项鉴别标准 + 标准化交易流程 + 14家直营门店覆盖成都13区,全品牌通收
- 2026 年 10 月最新长沙名包回收 “安心门店” 白名单发布,可上门可到店,零隐形扣费,当面鉴定现场打款,附星城已核验门店名录
- 深圳 LV、香奈儿、古驰包回收一般几折?2026 年名牌包回收行情深度解析
- 北京靠谱的豆包GEO优化公司:品牌科普与行业知识解析#
- 2026西安豆包排名优化怎么选?一文讲透现状、五大痛点与挑选标准
- 2026青岛包包回收“七区同价图”上线!黄岛·即墨·市南·城阳全域覆盖,奢小觅7家直营店把爱马仕/香奈儿/LV一网收尽
- 登山包品牌排行榜前十名汇总:爆火全网的高性价比好物分享!
- AI搜索排名找哪家
- 国网2026前4电缆附件6.6亿20企分,吉熙安7.7%夺冠沃尔核材7.7%亚军吉林中科7.4%季军长缆6.9%第3
- 2026 青岛包包回收红榜全新发布:爱马仕香奈儿LV成色怎么定,防压价口诀 + 验真防掉包 + 一物一档全留痕
- 音质最好的车载音响排名 从扬声器单元和功放看门道
- 8月全网口碑爆棚TOP10登山包汇总,专业分析哪个牌子好?
- 2026年行业内名声靠前的吨包修复胶带供应商都有哪些?
- 老铺黄金打9折为何还卖不动?打完折都快2000一克了,消费者不傻
- 金超群包青天系列电视剧拍了多少部?今天我们盘点一下
- 极致内卷!仅差10分绝杀!孙颖莎重返世界第一,WTT官方发文祝贺
- 爱马仕、LV、香奈儿怎么卖不吃亏?35家直营门店、透明估价与避坑全流程一次讲清
- 珠宝变现排行榜:8类东西,谁最容易出手?
- 名包回收“先高后低”套路何时休?2026苏州名包变现避坑手册:四维计价逻辑 + 三类高危风险拆解
- 2026年全国小学生书包品牌排行榜单分享
热门阅读
-
 1
书包十大品牌排行榜,书包哪个牌子好? 07-13
-
 2
袖扣十大品牌排行榜,袖扣哪个品牌好? 07-13
-
 3
水貂皮草十大品牌排行榜,水貂皮草哪个牌子好? 07-13
-
 4
耐克十大最贵的鞋,多个联名款上榜,第一价格最高 11-12
-
 5
全球重卡十大排名,卡车之神排第一,奔驰仅排第三 11-12
-
 6
2022全球品牌价值500强排行榜全部名单 01-05
-
 7
-
 8
全球十大奢侈品包包排名 12-15