谷歌HOPE架构来了!突破大模型长期记忆难题,智能体要爆发?
日前,Google在其发布的论文《Nested Learning: The Illusion of Deep Learning Architectures》中,提出了一个名为 HOPE 的新框架试图解决大模型长期记忆的问题。
这一架构备受关注,因为长期记忆一直困扰着大模型的发展,甚至影响着AI落地到智能体的广度与深度。
今天让 AI 写一段漂亮的回答不难,难的是隔了一周、换了工作任务,它还记得你之前某次对话的关键细节,不断更新对你的个性化记忆。也只有在这一刻,大模型才真正开始接近「持续工作的智能体」,而不是一次性消耗品。
可以说,大模型的「短期能力」决定了它能不能把一句话说通,但长期记忆真正决定的,其实是它有没有资格被称为「助手」。
也正是因为这一点,去年最后一天谷歌研究团队提出的 Titans 架构,在 2025 年被反复翻出来讨论,并不意外。这篇论文试图回答的,并不是「上下文还能拉多长」这种老问题,而是一个更本质的命题:
当注意力只是短期记忆,大模型到底该如何拥有真正的长期记忆。
图片来源:谷歌
在 Titans 里,Transformer 的 self-attention(自注意力机制)被明确界定为「短期系统」,而一个独立的神经长期记忆模块,负责跨越上下文窗口、选择性地存储和调用关键信息。这套思路,几乎重新定义了大模型的「大脑结构」。
现在回头这一年,从谷歌 Titans 到字节 MemAgent,再到谷歌 Hope 架构,大模型的长期记忆真正有了突破。
过去一年,不论是谷歌在此基础上延展出的多时间尺度记忆体系,还是行业里围绕超长上下文、智能体(Agent)记忆、外部记忆中台展开的密集探索,都指向同一个趋势:长期记忆,正在从工程补丁,变成大模型能力的核心坐标轴。
模型不再只比谁的窗口更长、参数更多,而是开始比谁记得更有选择、更稳定、也更「像人」。大模型的长期记忆不再只是论文里的性能指标,而是决定「能不能长期被用、敢不敢被信任」的关键能力。
从 Titans 到 Hope,长期记忆在为智能体「打基础」
今年 8 月中旬,谷歌为 Gemini 推出了两项重大更新,分别是基于聊天上下文的「自动记忆」功能和保护隐私的「临时聊天」模式。
顾名思义,「自动记忆」是指 Gemini 会通过学习用户过去的聊天记录,记忆对话中的关键细节、用户偏好、长期项目背景、反复出现的需求等,并在后续回答中实现主动的个性化回答。
类似的变化并不只发生在 Gemini 身上。过去一年,从 ChatGPT、豆包到 11 月推出的讯飞星火 X1.5,几乎所有头部 AI 助手都在通过引入「长期记忆模块」,努力让大模型在跨会话、跨场景中保持连续性,让 AI 能够更新并记忆用户画像、历史任务状态和关键决策信息。
图片来源:科大讯飞
不过继续向上追溯,这一波产品层的变化,并不是孤立发生的,而是 2025 年大模型底层技术演进的直接结果。
首先被重新确认的一点是,长上下文不是大模型记忆的终点。
超长上下文仍然重要,但它越来越被视为一种「放大的短期记忆」——成本高、也无法判断哪些信息值得被长期保留。而 Titans 的意义,并不在于把窗口再拉长,而在于明确区分:注意力只是短期系统,长期记忆必须是一个可持续更新的组件。
11 月,谷歌更是提出将模型训练过程也视为一层记忆(Nested Learning),并给出了升级版的 Hope 架构,开始把「记忆」理解为多时间尺度的连续体,短期上下文、中期状态、长期经验不再是割裂的模块,而是按更新频率和稳定性分布在同一套学习系统中。
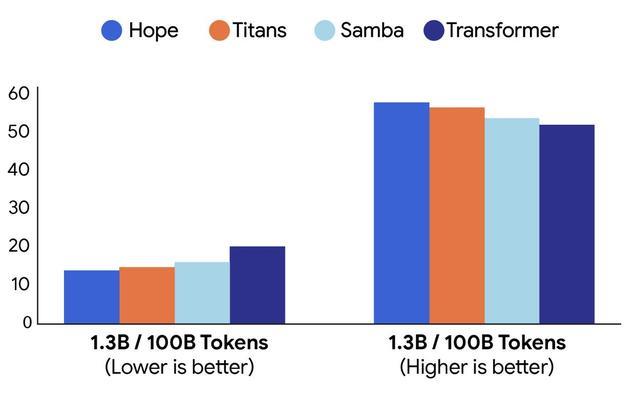
Hope 与 Titans、Transformer 架构对比困惑度(左)和常识推理(右),图片来源:谷歌
与此同时,长期记忆的重心从「记住文本」转向「记住经验」。过去常见的做法是用向量数据库或知识库做 RAG,把它当成模型的「外部硬盘」。但现在这种做法正在被重新审视,长期记忆不只是检索答案,而是需要参与推理过程,影响模型的决策和行为。
还是在 11 月,谷歌提出 Evo-Memory benchmark 和 ReMem 框架,明确将长期记忆放入智能体的工作流中考察:模型是否能在连续任务中提炼经验、复盘策略,并在后续任务中真正用上。长期记忆不再只是为对话服务,而是直接决定智能体是否具备持续进化能力。
事实上,字节跳动与清华联合提出的 MemAgent,则通过强化学习训练模型在超长上下文中「学会取舍」,让模型主动形成长期记忆习惯,而不是被动堆叠文本。这些工作虽然路径不同,但都指明了长期记忆必须逐步内化为模型能力,而不只是工程外挂。
长期记忆的中国路线:MiniMax/豆包/DeepSeek有何不同思路?
今年年初,MiniMax 宣布了首个线性注意力架构大模型开源,官方就指出现有智能体的「长期记忆」大多只是外挂 RAG 工具,这严格意义上不算记忆。
事实的确如此。在早期实践中,向量数据库加 RAG 几乎是默认方案:需要记住什么,就检索什么。但随着智能体逐渐承担多步骤任务,这种「查完就走」的记忆方式开始显得吃力。
最近豆包手机引爆了业界关于AI手机的讨论,其实豆包在 Agent 体系中关于长记忆的探索也具有很强的代表性,其长期记忆被拆分进整个工作流,用来保存用户画像、任务状态、阶段性结论,甚至失败经验。
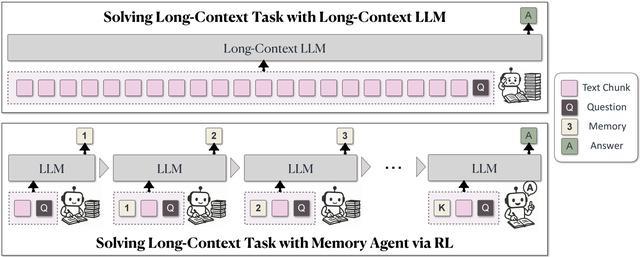
MemAgent 的基本结构,图片来源:字节跳动
MemAgent 这一类方案,本质上并不是在扩展上下文长度,而是在训练模型理解哪些信息会影响下一步决策。简言之,记忆不再是查资料,而是参与判断。
从这个角度看,字节与清华联合提出的 MemAgent 并不是一篇孤立的学术工作。它关注的,并不是如何压缩文本或扩展容量,而是通过强化学习,让模型在超长上下文和连续任务中逐渐学会「取舍」。模型需要理解哪些信息值得保留,哪些只适合短期使用,甚至哪些应该被主动遗忘。
背后也体现了一种非常明确的判断,即长期记忆如果不能改变模型的行动策略,本质上仍然只是工程缓存。
正如前文所提,不论是行业的实践,还是围绕智能体展开的多种系统设计,都在强调对「过程信息」的保留。这也解释了为什么强化学习开始被用于「记忆行为」的训练,而不是简单地扩大知识库。
与之不同的是,MiniMax 在今年初就通过线性注意力等架构创新,把模型可处理的上下文推至百万乃至数百万 token 级别。
这并不是单纯为了刷新指标,而是试图用容量换取系统简化。当模型本身一次可以稳定「看见」更多内容时,部分原本需要频繁调度、反复检索的外部记忆,就可以暂时被收进上下文视野之中。
但 MiniMax 的实践并没有停留在「超长上下文窗口」。
图片来源:MiniMax
相反,他们在此基础上继续引入独立的记忆层,用于管理长期知识与经验。先解决「装不装得下」,再讨论「该不该留下来」。在这种框架下,长期记忆不再完全依赖于频繁的 RAG 调用,而是通过更大的模型内视野与更少的系统切换,降低整体复杂度。
而 DeepSeek 的策略,则构成了一个有意义的对照。DeepSeek 并没有在模型侧押注复杂的长期记忆机制,而是将其明确外置,通过 RAG、向量库或各类记忆组件完成。倒不是在回避问题,而是基于一个更克制的判断:
长期记忆高度依赖具体场景,不同应用需要的记忆形态差异巨大,与其在模型里「一刀切」,不如提供一个高质量的推理核心,让开发者自行组合记忆方案。
写在最后
2025 年,大模型长期记忆真正发生变化的,并不是某一项指标被刷新,而是它的角色定位被彻底改写了。从早期依赖 RAG 的「外接硬盘」,到今天逐步进入模型结构与智能体工作流,长期记忆开始成为影响决策、塑造行为的一部分,而不只是被动存储信息的容器。
或许可以这么说,未来大模型之间真正的差异,不再只体现在模型规模或推理速度上,还在于一套成熟、可控、可持续演化的记忆机制。因为只有当一个模型真正记得住、也管得住,它才有可能被长期使用、反复依赖,甚至被交付更大的决策权。
CES2026开幕在即!(1月6日-1月9日)
作为中国报道科技展会最悠久、最深入、最专业的新媒体,雷科技CES2026报道团正在进行紧张的前期筹备。届时雷科技将派出史上最大规模的CES报道团,并由雷科技创始人兼总编辑罗超带队,对CES2026进行一线、专业和立体报道,敬请期待!
大家都在看
-
以科技之力,重塑博物馆的智慧未来 当博物馆的使命从“收藏过去”延伸至“连接未来”,管理的内涵也在发生深刻变革。传统博物馆面临的信息孤岛、管理粗放、决策滞后等痛点,正呼唤一套能够统揽全局、数据驱动、智能运营的解决方案。智云控CIC智慧文博 ... 科技之最09-15
-
"数据要素×"二等奖,中之杰科技的工业智能体从赛场走入工厂 宁波2026年9月15日 /美通社/ -- 日前,2026年"数据要素×"大赛浙江分赛宁波站落幕。在以"数智汇甬•词元赋能——激活数据要素产业新动能"为主题的赛场上,中之杰科技凭借"工业大模型+智能体驱动离散制造全链协同"这 ... 科技之最09-15
-
95后清华核科技女博士,到利川当村支书,有人说她冲动,有人觉得这是大材小用;本人:反差的确很大,不过收获的远比付出的多 “镜头低一点,人民高一些!”9月10日,恩施州利川市凉雾乡诸天村村民粟艮树点开微信视频号,就听到一个熟悉的声音。他高兴地把手机举到妻子面前,“你看,咱们的书记又发视频了,还有咱俩的镜头呢!”妻子看着视频 ... 科技之最09-15
-
昨天,弥勒一中学子追到了“科学之星”! “科学家进校园”腾冲科学家论坛基金会公益科普活动走进弥勒一中9月13日上午,“科学家进校园”腾冲科学家论坛基金会公益科普活动在弥勒市第一中学举行。腾冲科学家论坛联合主席、中国科学院院士、北京大学原校长许 ... 科技之最09-14
-
改变人类命运的5大科技!我们天天在用,很多人却一无所知 彻底改写人类命运!5项改变世界的科技突破,我们每天都在享受红利 很多人总觉得,改变世界的高科技,都是遥不可及、藏在实验室里的复杂产物。 其实真正厉害的科技突破,从来都不是花里胡哨的噱头,而是悄无声息融入 ... 科技之最09-14
-
世界之最 拱立巅峰! 科技创新是高质量发展的核心引擎,是发展新质生产力的关键支撑,也是八桂大地转型升级的澎湃动能。前不久,一年一度的广西科学技术奖励大会,集中揭晓2025年度全区重磅科技创新成果,彰显广大科技工作者勇攀科学高峰 ... 科技之最09-14
-
不碰骨头,如何解开你身上最疼的那个“结”? 百年技艺如何拥抱现代科技?她用行动破局解开非遗传承的困结本期《为你喝彩》带您走近北京市海淀区级非物质文化遗产项目何氏通络开结术 代表性传承人何银萍“开结不碰骨”是何氏通络开结术延续百年的核心思路所谓“ ... 科技之最09-14
-
“最美教师”张福锁:课堂搬进庄稼地,扎根科技解民生 第42个教师节来临,中国工程院院士、中国农业大学教授张福锁获评2026年“最美教师”。从教四十余年来,张福锁以田间为课堂,扎根科技小院解民生、治学问、育英才,把论文写在大地上。他推动课堂向真实场景延伸,与学 ... 科技之最09-14
-
现场直击!武汉科技大学2026年研究生新生开学典礼! 9月11日上午武科大隆重举行2026年研究生新生开学典礼典礼在黄家湖校区沁湖礼堂设主会场青山校区碧园会堂和各培养单位设分会场通过视频直播方式同时进行党委书记倪红卫,党委副书记、校长吕勇等全体在校校领导,各有 ... 科技之最09-12
-
中美科技实力到底怎样计算? 一、一个国家能得多少“科技分”,取决于谁在出题比较中美科技,最常见的方法是各选一张有利榜单:研发投入、论文、专利、模型、企业市值,谁在哪张榜上领先,就宣布谁已经全面领先。但这些数据并不处在同一环节。有 ... 科技之最09-12
相关文章
- 现场直击!武汉科技大学2026年研究生新生开学典礼!
- 中美科技实力到底怎样计算?
- 他们让晶体管开关越过60毫伏物理红线,芯片功耗迎来新解法
- 浦江创新论坛发布首届“浦江科学之问”,“十问”为基础研究布局提供方向指引
- 上海发布“面向未来的十大科学问题”!赵东元:期待下一个牛顿、爱因斯坦诞生
- 浦江科学之问:探寻基础研究的源头活水
- 2026浦江创新论坛首发十大科学之问 “人工智能的数理基础”等入选
- 浦江创新论坛又一年,透视上海科创的“点线面”
- 强国矩阵系列之科技强国 引领无人区 突破国家领导力 极化产业创新力
- 向科学进军70年
- 外媒罕见报道:中国科技最擅长从 2 到 100,但 从0 到 1仍存在明显短板
- 大唐盛世100史·第44期】工艺科技鼎盛,天文历法,手工业冠绝当世
- 穿了跟没穿一样的内裤,真的太爽啦!
- 深圳,后海不是海
- 服贸会怀柔展区科技感拉满,票根还能享优惠
- 终于不挤牙膏!iPhone18 Pro全面大升级,续航直接创下历史之最
- 最被平民低估的圣人墨子:两千年前的之光,温柔又硬核
- 深圳坪山街道“家门口的科学课”,孩子们玩嗨了
- 264十度解码:中国500强中天科技集团十度模型健康度全景评价报告
- 不止祭天:天坛藏着古人最顶级的时空与科学密码
热门阅读
-
 1
万事胜意不能乱说的原因?告诉你万事胜意该对谁说 12-09
-
 2
科威特第纳尔为什么那么值钱?比美元值钱的货币盘点 12-22
-
 3
撕心裂肺十大催泪情歌,10首哭到崩溃的歌曲 12-24
-
 4
不敢公布马航真实原因,内幕曝光简直太惊人! 12-25
-
 5
陈百强什么原因怎么走的,陈百强85事件是什么 01-05
-
 6
麻将公式一定要背下来,麻将手气背转运小妙招 01-19
-
 7
科学家发现上帝的存在,神仙真实存在的十个证据 04-29
-
 8